
核心结论
robots.txt 管爬虫能不能抓取,noindex 管页面能不能放进搜索结果,sitemap.xml 只列希望被收录的规范公开网址。想屏蔽页面不能只靠 Disallow,否则爬虫读不到页内 noindex。正式开放收录须同时满足正式域名、HTTPS、生产环境标记与显式索引开关四项条件,本地预览与测试环境始终禁止收录。
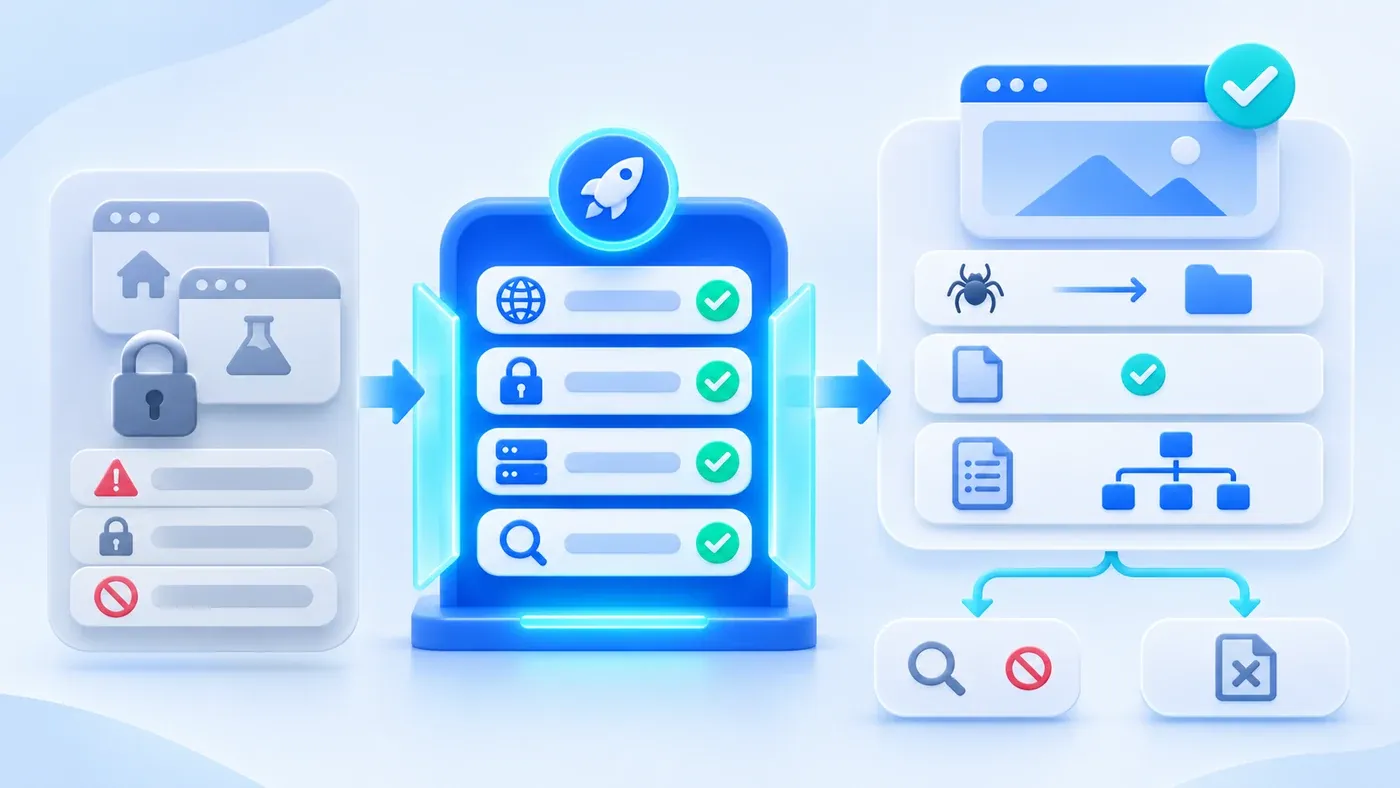
新网站上线切换时,最常让团队措手不及的往往不是视觉或文案,而是几行决定搜索引擎能否抓取与收录的技术配置。实际交付中,有三类上线事故反复出现:
- 新站上线两周搜索还找不到,排查才发现测试环境遗留的全局
noindex或Disallow: /忘了摘; - 想屏蔽后台、预览页和站内搜索页,却用
robots.txt一刀封住,导致曾被抓过的链接因爬虫读不到页内noindex标签,一直挂着“无摘要描述”留在结果里; - 上线后
sitemap.xml报错,因为导出逻辑把草稿、咨询辅助页、带?q=的站内搜索页或404地址全塞进了站点地图。
根源在于把三者当成可互相替代的“隐藏或提交开关”。实际上,它们分别把守抓取、索引与规范网址推荐三个环节。协调这些配置有助于排查上线问题(对应 SEO 和 GEO 怎么配合:企业内容团队的双轨策略 的技术健康要求),但它只提供合规资格,不承诺收录速度或排名。
先理清分工:robots.txt、noindex 和 sitemap.xml 各管哪一关
- robots:抓取范围
- noindex:索引选择
- 站点地图:规范地址
- 鉴权:私密访问保护
正常栏目分页与无价值筛选变体分别判断;私密内容继续保持鉴权。
在搜索引擎处理流程里,三项规则有严格先后顺序,前一道关口配置不当,后一道指令就会失效。
1. robots.txt:管“能不能来抓”,不管“绝对不出现在结果里”
依据 Google 搜索中心《robots.txt 简介》,robots.txt 用于告知遵守规范的爬虫哪些路径可访问,核心目的是管理抓取流量。须守住三条边界:
- 被
Disallow仍可能展示 URL:若其他网页链接了被禁抓地址,Google 仍可能在不访问正文时编入该 URL(通常无摘要)。它不能替代noindex,也别用它拦截渲染所需的 JS、CSS 或图片。 - 不是安全机制:恶意脚本可无视该文件,且
/robots.txt公开可读,写入后台路径反而暴露目录。后台与草稿须靠登录鉴权保护。 - 严格绑定主机、协议与端口:按 Google 对 robots.txt 规范的解释,
https://www.example.com/robots.txt只作用于 HTTPS 的www.example.com,不覆盖http://或子域;若/robots.txt返回4xx(429除外),爬虫视为无抓取限制。
2. noindex:管“能不能放进索引”,前提是让爬虫先抓得到
依据 Google 搜索中心《使用 noindex 阻止搜索引擎编入索引》 与 Robots meta 标记和 X-Robots-Tag 规范,阻止网页或文件进入索引有两种等效写法:HTML <head> 里的 <meta name="robots" content="noindex">,或响应头 X-Robots-Tag: noindex(适合环境全局下发及 PDF、图片等非 HTML 文件)。
最关键的配合规则:Google 不支持在 robots.txt 中写 noindex,且必须允许爬虫访问页面或响应头,它才能看到 noindex。若已收录旧链接(如 /search?q=... 或测试页)既加 noindex 又被 Disallow 封住,爬虫读不到指令,旧址就会滞留在结果里。对已经公开且可访问的残留地址,可让爬虫读取 noindex 或真实 404/410。私密测试站、后台和草稿应持续保持鉴权,不能为了清退索引先开放内容;还需修正外部链接与站长平台中的相关记录。
3. sitemap.xml:只列希望被抓取和索引的规范公开 URL
依据 Google 搜索中心《构建并提交站点地图》,sitemap.xml 集中列出希望展示的规范公开 URL。编写须守住四点:UTF-8 编码,单文件 ≤ 50MB 且 ≤ 50,000 条 URL,放站点根目录;使用含协议与正式域名的绝对网址;只放返回 200、允许索引且当前语言已完成的版本;Google 忽略 <priority> 与 <changefreq>,仅在 <lastmod> 准确反映正文、结构化数据或链接实质更新时参考。把草稿、站内搜索或 noindex 页放进站点地图会发出矛盾信号。正文结构写法可参考 AI 更容易引用什么内容。
4. 补齐 404 / 410 状态信号
依据 Google 搜索中心对 HTTP 状态码的说明,已删除且无替代跳转的 URL 须返回真实 HTTP 404 或 410(勿返回 200 软 404),且不要在 robots.txt 拦截,便于爬虫核实后移出索引。
测试环境、本地预览与正式环境怎么用开关隔离?
指望上线当天“靠人肉去删掉一行 noindex”迟早会出事故。更关键的原则是:绝不能为了图方便而开放本地预览环境(如 127.0.0.1、localhost)或临时测试环境的搜索引擎收录——本地与测试环境既不是稳定可访问的公开服务,也包含未定稿内容,任何时候都应强制锁定为禁止索引。
下面给出一套默认关闭、四项条件齐备才开放的部署示例;变量名和域名约束由项目实现,并非 Google 规定的唯一条件。HTTPS 是安全部署建议,站点地图也是发现网址的提示,都不是单独的收录保证。只有下面四项全部满足,网站才允许开放正式收录:
- 正式公开域名:运行时基础地址命中已批准的生产域名,排除
localhost、127.0.0.1、IP 地址和staging.子域; - 公网 HTTPS 协议:必须运行在
https://下,确保规范地址、robots.txt与sitemap.xml不泄漏http://; - 生产环境标记:部署变量明确为生产环境(例如示例配置中的
WEBSITE_ENV=production),本地与预发布标记一律锁定; - 显式开启索引开关:独立开关变量显式启用(例如
WEBSITE_INDEXING=enabled),未配置或拼写错误时默认回落为禁止索引。
即使四项条件在生产环境全部满足,路由与页面级的保护仍须无条件优先:管理后台与登录态草稿预览继续鉴权并禁止索引;站内搜索及勾选 noIndex 的公开页可保留 noindex,是否跟随链接另行决定,不必一律 nofollow。不希望索引的地址不纳入正式提交的站点地图。对于部署在公网上的预演环境,优先使用密码或 IP 限制;若需免登录给内部试看,则统一返回 X-Robots-Tag: noindex, nofollow 并关闭站点地图。
生产环境切换就绪后,根目录 /robots.txt 保持简洁清晰(以下为虚拟示例域名):
User-agent: *
Disallow: /admin/
Sitemap: https://www.example.com/sitemap.xml
/sitemap.xml 则只输出可正常访问的规范 HTTPS 页面:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.example.com/zh/services/website</loc>
    <lastmod>2026-11-16</lastmod>
  </url>
</urlset>
如果中文站和英文站分设在独立正式域名下,每个域名根目录都需要各自配置独立的 /robots.txt 与 /sitemap.xml;双语页面之间的 canonical 与 hreflang 对应关系则按跨语言互指规范另行核对。
官网五类页面的 robots、noindex 与 sitemap 配置对照表
官网页面类型 | | | 是否进 | 关键原因与避坑提示 |
|---|---|---|---|---|
公开核心页(首页、服务、方案、案例、已发布文章) | 允许抓取(放行页面及渲染用 JS/CSS) | 返回 | 建议列入(仅限已发布且当前语言完成页) | 确保正文可抓取可索引;切忌把测试环境的全局 |
站内搜索与无独立价值的筛选变体( | 需让爬虫读取 | 通常返回 | 不列入希望索引的正式地图 | 依照 Google 分页指南区分普通分页与无价值参数变体;已有公开残留地址应让爬虫读到清退信号。 |
草稿预览与管理后台( | 可加 | 强制登录态鉴权(未登录返回 | 严禁进入 | |
测试与本地预览环境( | 永不开放本地预览收录;公网测试站优先设密码/IP 访问控制 | 四重开关未齐备,全局强制 | 不对外提交测试地址地图;内部演练可保留受控地图 | 避免测试克隆与正式站竞争或提前泄漏;曾被收录的私密站仍保留鉴权,不能先公开资料等待清退。 |
404 与已下线无替代页(错链、已删除内容) | 禁止在 | 返回真实 HTTP | 严禁进入 | 爬虫必须访问后收到 |
网站上线前 10 分钟索引验收检查清单
切换正式域名与打开索引开关后,建议按下面这份清单在 10 分钟内完成全链路实测:
【网站上线前 10 分钟索引验收检查清单】

1. 本地与测试环境锁定核对(切流前)
- [ ] 本地预览环境(127.0.0.1 / localhost)仍保持禁止索引,未改动默认关闭规则。
- [ ] 公网测试环境已上访问密码或全局 X-Robots-Tag: noindex, nofollow,且正式站无指向测试域名的链接。

2. 生产四重开关一致性检查(切流时)
- [ ] 正式站同时满足:正式公开域名 + 公网 HTTPS + 生产环境标记 + 显式开启索引开关。
- [ ] 若中英文分域名部署,已分别核对两个域名下的开关与基础地址。

3. 正式站 /robots.txt 实测(切流后立即执行)
- [ ] 访问 https://<正式域名>/robots.txt 返回 HTTP 200,无残留 Disallow: /,公开 JS/CSS 可抓取。
- [ ] 文末 Sitemap: 指向完整的 https:// 正式域名地址,不含 http://、localhost 或测试域名。

4. 正反两组页面 noindex 抽检(查源码与响应头)
- [ ] 正向抽检首页、服务页、已发布文章:HTML <head> 与响应头均无 noindex 或 none。
- [ ] 反向抽检 /zh/search?q=test 与 /en/search?q=test:确认输出 noindex 且未被 robots.txt 拦截。
- [ ] 无痕浏览器访问 /admin 与未发布草稿预览 URL:确认拦截未登录访问并带 noindex, nofollow。

5. 正式站 /sitemap.xml 净度抽检
- [ ] 访问 https://<正式域名>/sitemap.xml 返回 HTTP 200 及 UTF-8 有效 XML。
- [ ] 抽查 <loc>:全部为 https:// 正式域名、已发布且语言完成页;零 /search、/admin、301 跳转或 404 地址。

6. 404 与旧链接跳转收尾
- [ ] 请求不存在路径(如 /zh/check-nonexistent-404)确认真实返回 HTTP 404 而非 HTTP 200。
- [ ] 抽查旧站跳转地址,确认单跳直达目标页(301/308)。

7. 上线后站长平台验证
- [ ] 在 Google Search Console 及目标搜索引擎站长平台验证正式域名并提交 sitemap.xml,用网址检查复核实抓状态。
理清 robots.txt、noindex、HTTP 状态码与 sitemap.xml 的联动顺序,有助于发现容易被忽略的配置问题。如果你正在整理旧站网址清单或筹备双语官网上线,可先配合 做网站之前先准备什么:项目准备清单 梳理域名与原有页面,或查看澄序元的 企业官网与独立站服务,带着当前网站结构与上线安排进一步沟通确认。
