
核心结论
从只读开始:独立只读账号、限定库表字段、参数化查询、超时与行数上限。AI 只生成查询,执行前经过模板校验或审批。结果要标明数据截止时间和口径,敏感字段脱敏。写操作不在第一阶段开放,任何绕过权限的临时办法都不采用。
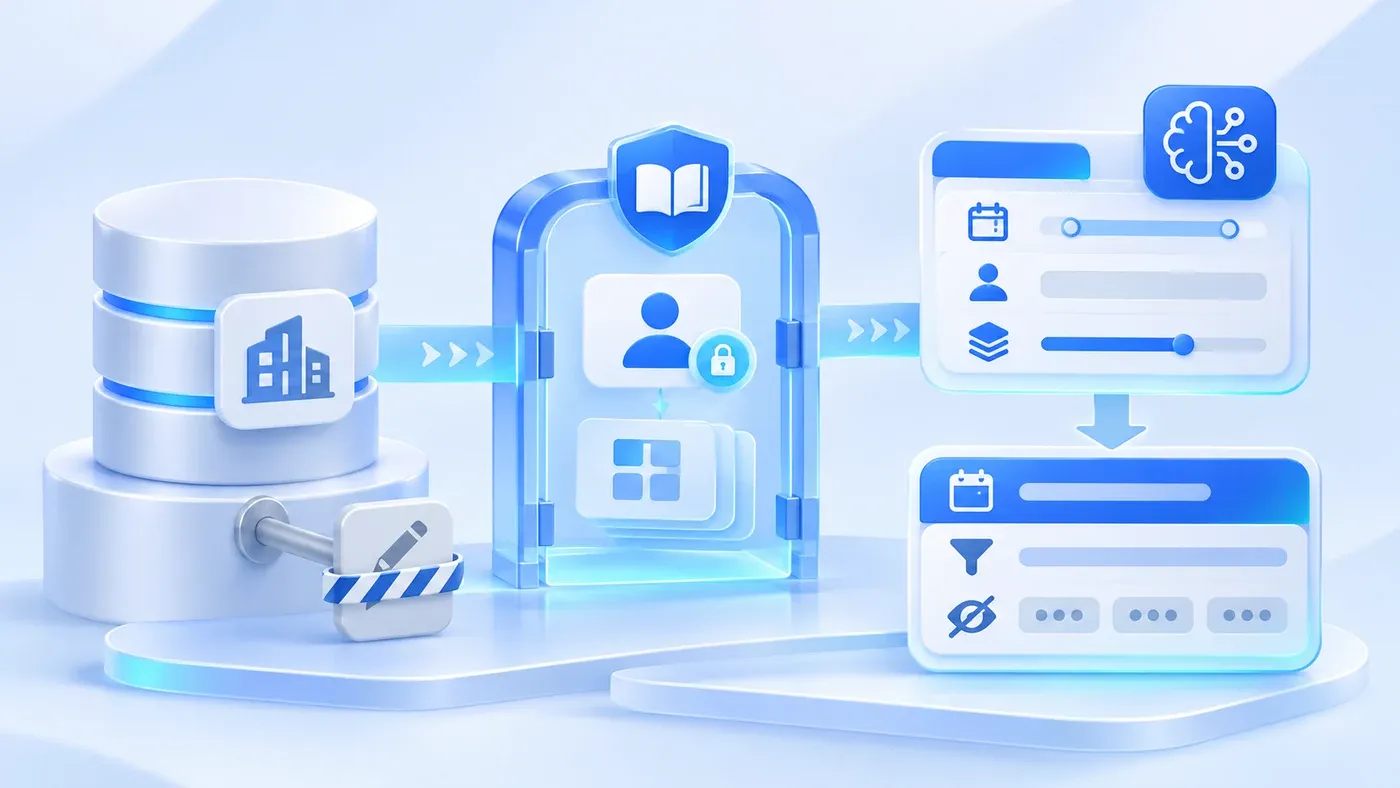
先看一个假设的例子:销售问 AI:“帮我查一下上周成交的客户,按金额排个序。”AI 生成了一条 SQL,连上数据库执行,返回了结果。整个过程很顺。后来做安全核查时才发现:这个账号连的是生产库,而且拥有写权限。只要有人让 AI“顺便把某个客户标记为已成交”,它也可能真的执行。
让 AI 查业务数据库,价值很直接:不用等报表排期,业务人员用自然语言就能拿到数据。风险也同样直接:一句模糊的话可能变成一条全表扫描,甚至一条修改语句。正确的起点是只读,而且不只是给账号加一个“只读”标签。
只读不是一个按钮,是一组边界
只读至少包含四层:账号权限、数据库会话模式、网络与连接范围、应用层查询限制。
账号权限决定能访问哪些库、表和视图。数据库会话模式可以再加一道限制。以 PostgreSQL 为例,SET TRANSACTION READ ONLY 会限制对非临时表执行 INSERT、UPDATE、DELETE、MERGE 和 COPY FROM,并限制多类 DDL;临时对象等细节仍须按所用版本文档核对。文档同时说明,这是高层面的只读概念,并不阻止所有磁盘写入。
因此,只读模式是纵深防御的一层,不是唯一保障。账号本身也不能有写权限,网络只能从指定服务发起,应用层还要限制查询类型。
账号与数据范围
为 AI 查询创建独立账号,不要复用管理员、报表账号或个人账号。只授予必要的只读权限,并优先通过视图暴露数据,而不是开放整张表。
视图可以预先限定字段和行范围:隐藏手机号、身份证号、银行账号、成本价;只保留业务查询需要的列。敏感字段即使必须提供,也应在结果层脱敏或按角色显示。
权限要跟着人员变化。业务人员调岗后,AI 查询账号的权限不应继续沿用;定期复核谁在使用、查了哪些数据。
查询生成与执行
不要让 AI 生成的 SQL 直接在生产库执行。更稳妥的做法是:AI 生成参数化查询,经过模板校验或人工审核,再执行。
参数化可以防止把用户输入拼进 SQL 造成注入,也让查询范围可控。模板校验可以限制允许的表、字段、聚合方式和排序字段。超出模板范围的查询,进入人工审核,而不是放开执行。
如果系统支持自然语言查询,也应把“生成查询”和“执行查询”分开记录:谁问的、生成了什么、谁批准、执行结果如何。
成本:超时、行数、频率
一条没有限制的查询可能扫描整张订单表,在业务高峰拖慢数据库。要设置:
- 超时:超过约定秒数自动终止。
- 行数上限:默认返回前 N 行,并提示还有更多结果。
- 并发与频率:限制同一账号或同一用户的查询频率。
- 只读副本:条件允许时,在只读副本上查询,减少主库压力。
上限的具体数值由数据库容量和业务高峰决定,不要照搬其他系统。上线前用真实数据量做一次压力测试。
结果核对与口径
查询结果要标明数据截止时间和统计口径。看板上的“昨天销售额”与数据库里的实时数字可能不同,原因是数据同步延迟、状态变化或去重方式不同。
结果里要写清:查询的是哪张表或视图、时间范围、包含哪些状态、是否去重。AI 不应把查询结果直接包装成“本月业绩”,除非口径已经确认。
对账类查询建议保留执行记录:问题、查询、执行时间、结果摘要。出现争议时,能回到当时查了什么。
写操作为什么先不开
写操作的风险不只是“改错一条数据”。它可能触发状态机、通知、库存扣减和财务记录。AI 对业务上下文的理解不足以承担这些后果。
第一阶段只读;确实需要写入时,走已审批的业务接口或人工操作,不由 AI 直接执行 SQL。任何“先开个写权限,出了问题再说”的临时办法,都不应采用。
假设流程
- 明确业务问题
- 生成并检查查询
- 最小权限执行
- 核对口径与截止时间
只读事务不能替代账号、行列权限、查询限制与结果核对。
步骤 | 做什么 | 谁负责 | 关卡 |
|---|---|---|---|
1 | 业务人员用自然语言提出问题 | 业务人员 | 问题需包含时间范围和对象 |
2 | AI 生成参数化查询 | 系统 | 只允许模板内的表和字段 |
3 | 校验或人工审核 | 数据或 IT | 超出模板则拒绝或转人工 |
4 | 只读账号执行 | 系统 | 超时、行数上限、频率限制 |
5 | 返回结果并标注口径 | 系统 | 敏感字段脱敏,显示数据截止时间 |
这套流程的目标不是让 AI 替代数据分析师,而是让常见查询更快、更可追溯。复杂分析仍应由人完成。
开放查询前,逐项确认只读边界
【AI 只读查询核对清单】

一、账号与范围
- 是否使用独立只读账号,未复用管理员或报表账号:
- 是否通过视图限定表和字段:
- 敏感字段是否隐藏或脱敏:

二、查询与执行
- 是否使用参数化查询:
- AI 生成的查询是否经过模板校验或人工审核:
- 是否禁止 DDL、写入和跨库访问:

三、成本
- 是否设置超时、行数上限和频率限制:
- 是否在只读副本上执行:
- 是否用真实数据量做过压力测试:

四、结果与记录
- 结果是否标明数据截止时间和统计口径:
- 查询与执行是否留下记录:
- 写操作是否明确不在第一阶段开放:先从一个只读视图和一个受限问题开始,例如“查某客户近三个月的订单状态”。跑通之后,再逐步增加视图和查询模板。接口级别的集成怎样分级,见AI 怎么接入 ERP 和 OA;动作权限与审批边界,见AI Agent 的权限、审批与人工接管边界。业务数据查询与 AI 工作流的具体范围,可以在AI 应用与流程里讨论。
