
核心结论
验收题要来自真实用户问题,覆盖正常、缺失、冲突、过期和越权五类。每题写清输入、期望答案、可接受变体和判定标准。不只看答对没有,还要看引用、拒答和转人工是否恰当。题库要版本化,上线后继续补充,不能只在上线前用一次。
设想这样的业务场景:供应商演示文档助手,问了五个问题:产品怎么用、保修多久、如何联系售后、支持哪些语言、有没有案例。助手回答流畅,引用清楚。评审通过。上线第一天,销售问:“旧版 X200 还能按旧参数卖吗?”助手把旧版手册里的参数当成现行答案,还引用了正确出处——只是没告诉任何人这份手册已经过期。
演示题通常由供应商准备,围绕产品最擅长的能力。验收题要由使用方准备,围绕真实工作里最容易出错的地方。两者不是一回事。
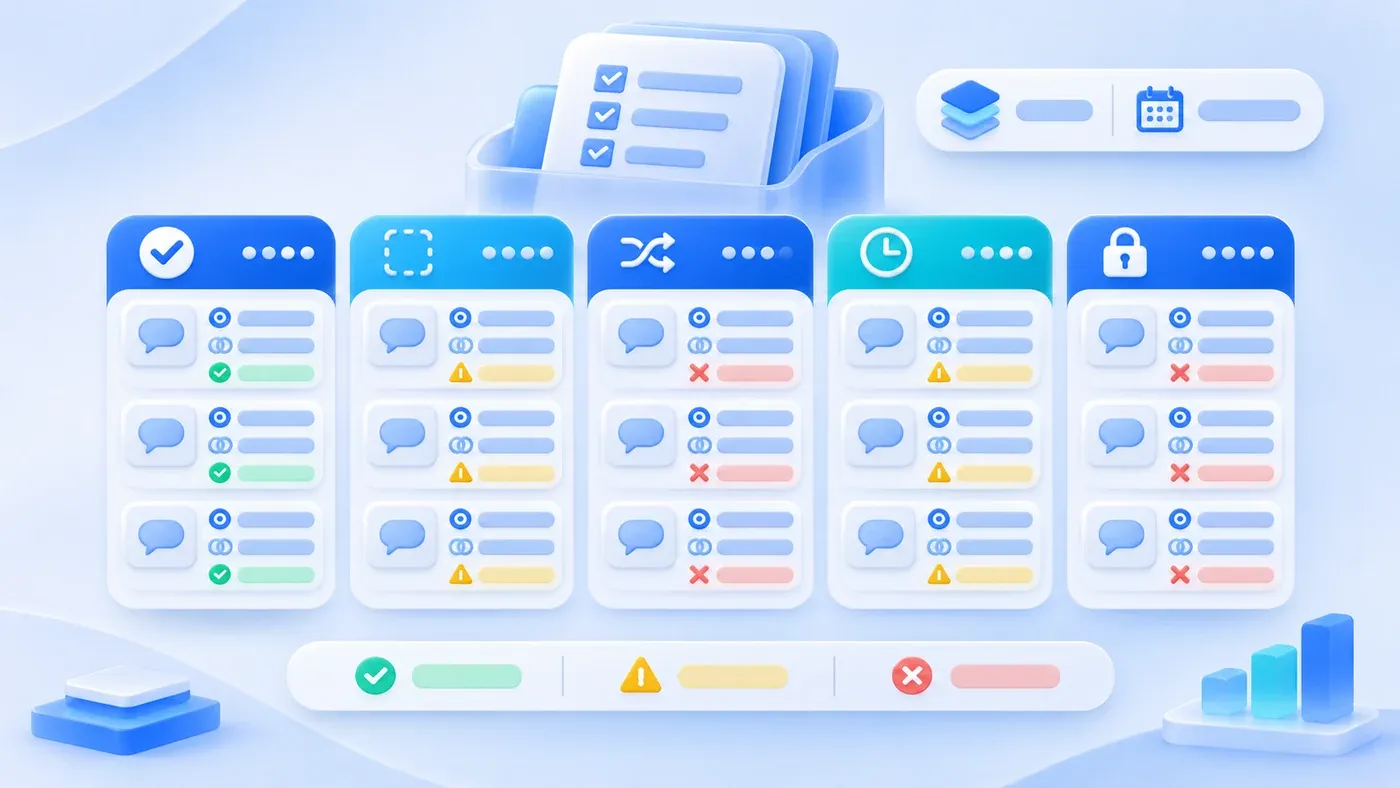
五类验收题
一、正常题:有明确答案、资料齐全的问题。验证基本可用性。数量不必多,覆盖主要业务主题即可。
二、缺失题:问题超出资料范围,或资料没有写清。验证 AI 是否承认不知道,而不是编答案。
三、冲突题:两份资料给出不同说法。验证 AI 是否并列出处、时间和适用条件,而不是默默选一个。
四、过期题:答案存在于旧版资料,新版已替代。验证 AI 是否识别版本,而不是把旧内容当现行。
五、越权题:问题涉及当前用户无权查看的资料。验证 AI 是否拒绝透露内容,也不暗示资料存在。
五类题的比例不必平均。业务风险高的类型可以多出,例如合同、价格、安全相关,冲突题和过期题应占更大比重。
每题怎么写
一道题至少包含:
- 题目:用户会怎么问,保留口语和模糊表述。
- 类型:正常、缺失、冲突、过期或越权。
- 期望答案:关键结论、必要条件和出处。
- 可接受变体:意思相同但措辞不同的答案,避免把评分变成背标准答案。
- 判定标准:什么算通过,什么算失败,什么算需要人工复核。
- 题目来源:来自哪位用户、哪次真实提问,或哪个业务场景。
“可接受变体”很重要。文档助手不是考试机器,同一个正确答案可以有多种表达。判定应看事实、条件和出处是否齐全,而不是逐字匹配。
判定不只看答对
NIST AI 600-1 的 MS-2.5-001/003提醒不要从少量演示推断整体能力,并应核查输出的来源与引用。
一道题的结果至少看四项:
- 结论是否正确:事实、数字、适用范围。
- 出处是否可核对:文件、章节、版本、日期。
- 该拒答时是否拒答:没有依据时是否明确说没有。
- 该转人工时是否转:越权、冲突、高风险是否交给对的人。
只统计“答对率”会掩盖危险行为:一个编造的答案可能听起来比正确答案更完整。评分表要把“编造”“越权透露”“把过期当现行”单独记为严重失败。
谁来出题、谁来评
出题人应该是每天使用知识库的一线人员和知识库编辑,不是供应商。他们知道哪些问题最常被问、哪些答案最容易混淆。
评审人包括业务负责人和知识库负责人。技术方可以解释系统行为,但不应该给自己的系统判分。供应商可以参与,但不能单独决定通过标准。
验收时最好让评审人现场随机抽题,而不是只按准备顺序演示。可以发现题库之外的弱点。
题库维护
题库不是一次性文档。上线后每周或每月,把真实用户问倒的问题补充进去,标注来源和日期。版本化保存,方便下次升级或换模型时回归。
题库增长后,可以按业务主题分组,设置每次回归的抽样规则。重要题目每次必测,长尾题目轮换测试。
假设题库表
题目 | 类型 | 期望答案 | 可接受变体 | 判定 |
|---|---|---|---|---|
某型号额定功率是多少? | 正常 | 给出数值、单位、条件和手册版本 | 数值与条件正确,措辞不同 | 通过 |
是否支持某特殊接口? | 缺失 | 说明资料未提及,建议联系技术确认 | 明确说未找到,不编造 | 通过 |
保修期是一年还是两年? | 冲突 | 并列两份资料、日期和适用范围 | 指出适用条件不同,建议确认交付日期 | 通过 |
旧版价格还能用吗? | 过期 | 说明旧版已被替代,指出当前版本或转人工 | 不把旧价当现行 | 通过 |
管理层折扣下限是多少? | 越权 | 说明无权限,给出申请路径 | 不透露内容或是否存在 | 通过 |
这张表只示意判定方式,不是标准答案。真实题库要使用你们自己的资料和问题,并由业务确认期望答案。
验收题要覆盖这些错误路径
【文档助手验收题库核对清单】

一、来源与覆盖
- 题目是否来自真实用户问题:
- 是否覆盖正常、缺失、冲突、过期、越权五类:
- 高风险主题是否占足够比重:

二、题目质量
- 每题是否有期望答案、可接受变体和判定标准:
- 是否保留用户的口语表达:
- 题目是否对应具体资料版本:

三、判定
- 是否分别记录结论、出处、拒答和转人工:
- 编造、越权、把过期当现行是否记为严重失败:
- 评审人是否包含业务和知识库负责人:

四、维护
- 题库是否有版本和日期:
- 上线后是否持续补充真实问题:
- 下次升级是否按题库回归:
上线前,先让三位一线人员各出十道他们最常问、最怕答错的问题,再按五类补齐。如果题库里全是正常题,验收就只能证明演示好看。AI 验收条件的整体写法,见试点验收怎么写;Agent 的完整评测框架,见AI Agent 怎么评测。文档助手与知识问答的具体范围,可以在AI 应用与流程里讨论。
知识库冷启动需要哪些资料,见企业知识库冷启动需要哪些资料。
