
核心结论
可核对的引用应让使用者看到有权访问的原文片段、版本、章节或页码,并能回到对应位置。定位字段随 PDF、扫描件、网页或表格而不同;扫描件需保留原图核对,深链接需验证阅读器支持,不能只凭文件名或一个生成角标认定答案有依据。
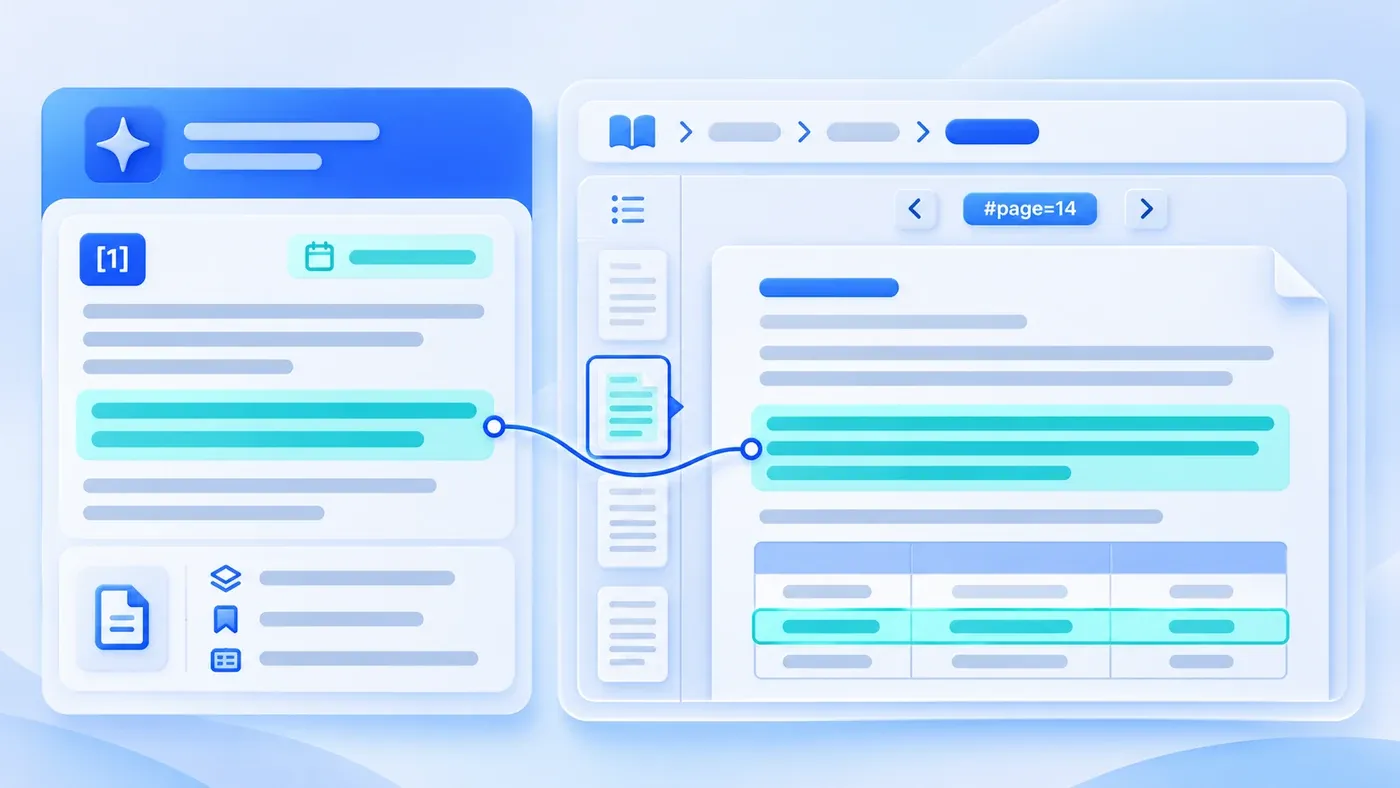
设想一套用于说明引用设计的知识库演示(假设场景):回答下面挂着一行小字——参考来源:《产品售后维保手册_最终版.pdf》。可真正交给客服或售后工程师用的时候,大家还是不敢直接把 AI 的话发给客户。原因很简单:那份 PDF 有 96 页,点击文件名只能从第 1 页封面打开;员工还得自己按 Ctrl + F 猜关键词去搜,要是遇到扫描版 PDF 或者 AI 把原文换了种说法,找那一段话的时间比不用 AI 还长。
虽然检索增强生成(RAG)从机制上允许系统将生成回答追溯到具体的被检索文本片段供人类核实(见 Lewis 等人 2020 年发表的 RAG 原始论文),但“底层检索到了某一段”不等于“界面上帮使用者回到了那一段”。若希望减少员工查找原文的步骤,系统必须在文档入库切分时就存好五项定位坐标,并在回答界面同时提供“句级角标、原文摘录抽屉、前后相邻段落”和“直达原文件对应页码/行列的链接”。
(如果你还不了解为什么有些文档连检索都搜不准,可以先看前序文章 文档格式为什么影响 AI 检索质量;本文假设系统已经召回了正确片段,专门解决使用者“怎么快速回到原文核对”的问题。)
定位与展示都要遵守原资料权限。扫描件中的 OCR 文本是识别结果,应标明这一点并提供对应原图,不能把它当作保证无误的原文;资料版本变化后也要重新核对页码和位置。
为什么只给一个文件名,员工还是不敢信
在业务现场,员工点开 AI 的参考来源,通常不是为了把整份文档重读一遍,而是为了确认三件大模型最容易出错的小事:
- 看前后文有没有限制条件:AI 总结了“质保期内免费更换压缩机”,但原文下一句紧跟着“若使用非标冷媒或未按期更换滤芯除外”。不看原文相邻段落,根本不知道有没有前提条件被省略了。
- 看数字和单位有没有张冠李戴:同一页表格里有“标准型 C200”和“低温型 C200-L”,AI 有没有把上一行的流量参数抄到了下一行?
- 看这份文件是不是当前还在生效的版本:文件名叫《最终版.pdf》,它到底是今年 3 月改过的现行规定,还是两年前作废的旧手册?
如果系统只丢出一个文件名,上面这三件事全靠人工重新大海捞针。久而久之,员工要么彻底放弃核对、盲目复制引发业务事故,要么干脆关掉 AI 助手,退回自己熟悉的文件夹去翻原件。
想要跳回原文,入库时就得存下这五项定位坐标
- 保留文档与版本
- 定位章节、页码或记录
- 展示有权访问的片段
- 核对原件与阅读器行为
扫描件需核对原图,深链接须测试目标阅读器,原文权限同时生效。
很多知识库之所以只能显示文件名,是因为在把长文档切分成小文本块(Chunks)入库时,解析程序把位置信息随手丢掉了。只要在切分阶段给每个文本块绑好以下五个元数据字段,前端就能拼出精准的回看路径:
1. 文档唯一标识与版本状态(doc_id + version + effective_date)
不要只存文件名。入库时应记录文档在知识库里的唯一编号、版本号(如 v2.4)、生效日期以及当前状态(现行有效/历史归档)。这样在答案卡片上,使用者一眼就能确认引用的不是过期文件(关于如何防止旧文档混入检索,可配合参考 知识库内容过期怎么办:从责任人到更新机制)。
2. 完整章节层级路径(heading_path)
把文本块所属的一级、二级、三级标题拼成一条面包屑路径保存下来,例如:第 4 章 售后资料登记 > 4.2 附件检查 > 4.2.2 缺件处理。即使员工手头拿的是纸质手册或没有页码的网页文档,顺着这条章节路径也能在几秒内翻到对应位置。
3. 物理页码、表格工作表与行号(page_no / sheet_row)
- 对 PDF 或固定版式文档:解析器在提取文字时必须记录该段落起始页与结束页(如
p. 34或pp. 34–35)。如果是双栏排版或扫描件,还可以额外保存外接矩形坐标(Bounding Box),用于在预览窗里直接给那一段画上高亮框。 - 对 Excel 或 CSV 表格:记录工作表名称(Sheet Name)、表头字段名以及原始行号(如
Sheet: 备件价格表, Row: 118)。
4. 原文精确摘录与字符偏移量(verbatim_quote + char_span)
AI 的主回答通常会做归纳改写,但引用卡片里必须保留一字不改的命中原文,并同时存下该片段的前一段和后一段(Parent Context)。这样使用者点开引用抽屉时,不用跳出当前窗口去加载几十兆的原文件,就能直接对比“AI 总结的话”和“原文上下三段话”。
5. 可直接打开对应位置的深链接(deep_link)
当使用者确实需要打开原文件查看完整大图或上下文表格时,链接不能只指向文件根目录:
- 对于浏览器内嵌预览的 PDF 文件,IETF RFC 8118(application/pdf 媒体类型规范)明确定义了
#page=<pagenum>和#nameddest=<name>等 URI 片段参数。将链接拼成.../manual-2026.pdf#page=34,支持该片段语法的阅读器可以尝试定位到 PDF 物理第 34 页;这不保证所有浏览器、内嵌容器或下载模式都执行跳页。验收时需测试目标阅读器,失败时仍显示页码、章节路径和查找说明。 - 对于企业内部 Wiki 或网页文档,则使用带标题
id的锚点链接,直达对应小节。
四类常见业务文档的原文定位方式对照表
不同格式的资料,定位粒度与实现成本不同。在规划知识库需求时,可以按下面这张表确定每类资料的回看标准:
原始资料类型 | 仅给文件名的问题 | 推荐保存的定位字段 | 使用者点击后的最佳回看体验 | 常见例外与兜底处理 |
|---|---|---|---|---|
数字原生 PDF(手册、合同、制度汇编) | 几十页文档从头翻,且 AI 改写后无法用关键词搜到 | 文档版本、章节路径、物理页码( | 侧边栏直接展开命中段落及前后文;点击“查看原页”通过 | 封面和目录常导致“印刷页码”与“PDF 物理页码”差几页,界面应同时标出 |
扫描版 PDF/图片单据(历史档案、盖章件) | 无法复制搜词,肉眼核对极慢 | 页码、OCR 识别文本、页面归一化坐标框 | 打开对应扫描页图片,并用半透明蓝色边框圈出 AI 读取的那几行原图区域 | 当印章遮挡或字迹模糊导致低置信度时,必须在答案旁显式提示“原件字迹模糊,请人工核对原图框选区” |
Word / 在线文档 / 内部 Wiki | 流式文档没有固定页码,不同屏幕打开页数不同 | 文档更新时间、完整多级标题路径( | 直接展示章节路径与原文段落;点击链接通过 | 若原文档没有规范使用标题样式(全用加粗代替标题),需在入库前先做结构清理或按段落序号定位 |
Excel / 结构化规格表 | 知道来自哪张表,却不知道看哪一行、哪一列 | 工作表名(Sheet)、主键值(如型号编码)、列标题名、原始行号 | 在引用区直接渲染命中的那几行小表格(带完整表头),标明 | 存在合并单元格或跨列备注时,必须把表格底部的“表注/说明行”一并附在引用卡片下方 |
可核对的 AI 答案卡片应该长什么样(假设示例)
下面用“售后资料是否齐全”演示引用卡片。文件、规则和所谓原文均为合成材料,不对应真实客户制度,也不构成设备操作或服务承诺。
假设使用者问:“只有设备编号,能否把这条事项标为已受理?能直接告诉客户完成日期吗?”卡片需要把两个判断分别连接到出处,而不是在底部堆两个文件名。
【AI 整理结果:合成演示】
1. 先登记为“待补资料”,补齐问题描述和必要附件后,再由指定人员核对是否转为“已受理” [1]。
2. 资料尚未核对时,不自动承诺完成日期 [2]。

【出处卡 1】《售后资料登记规范》|demo-v1(合成)
- 章节:资料检查 > 缺件处理
- 位置:PDF 物理第 4 页,登记表“附件状态”列
- 演示定位:support-intake-demo-v1.pdf#page=4(不是实际下载地址)
- 合成原句:“设备编号、问题描述和必要附件未核对齐全时,记录为待补资料。指定处理人核对后,方可转为已受理。”

【出处卡 2】《外部回复核对清单》|demo-v1(合成)
- 章节:进度回复 > 尚待确认的信息
- 位置:第 2 节
- 合成原句:“未核对的处理时间保持待确认,不把内部估计写成已经承诺给客户的完成日期。”
这张卡的用途是让使用者看见“资料齐全”与“指定人员核对”这两个前提,并区分登记状态和对外承诺。出处展示不是审批通过:用户仍需按自己的业务规则确认答案是否适用。
验收 AI 知识库引用定位时的五项检查清单
如果你正在评估或验收一套企业知识库,不要只看演示时的问答流不流畅,拿下面五道题现场测一遍即可:
- 角标是不是绑在具体句子上? 当一段回答综合了两份文档时,能否看清哪句话来自文档 A、哪句话来自文档 B?
- 不点开大文件能不能先看原文段落? 界面有没有直接展示命中的一字不改原文,以及它的前一段和后一段?
- 点击原文件能不能直达对应页或对应小节? 点开 50 页以上的 PDF,是停在第 1 页封面,还是直接跳到了命中页码?
- 表格数据有没有保留表头和单位? 如果答案引自表格,引用卡片里能不能看清行号、列名和计量单位?
- 版本和生效时间清不清楚? 引用卡片上有没有标明这份资料的生效日期或版本号,防止员工拿着旧制度去答复新业务?
把“回到原文那一段”做好,员工才敢真正把 AI 当成日常工作台的一部分,而不是一个需要提心吊胆猜对错的黑盒。如果你正在规划企业内部资料检索、知识库问答或业务流衔接,可以查看我们的 AI 应用与流程服务 了解实施方法,或带着现有的文档样本通过咨询入口与我们探讨适合你们资料结构的定位与核对方案。
